GitHubは2026年10月5日、AIコードレビューを共通の条件で比べる評価基盤「ReviewBench」の研究プレビューを公開しました。
AIにコードを見てもらうと、多くの修正候補が返ることがあります。でも、指摘が多いほど良いレビューとは限りません。重要な不具合を見つけたのか、問題のない部分にも修正を求めているのかで、負担は変わります。
この記事では指摘の正しさと、見逃しの少なさを分ける方法を整理します。開発担当者へ導入を相談するときにも使える判断軸です(出典:GitHubの発表)。
この記事でわかること
- ReviewBenchの役割:同じ条件でAIレビューを比較する仕組み
- 数字の読み方:精度と再現率の違い
- 実務での使い方:自分たちのコードでも確認する項目
ReviewBenchは、レビューの成績を比較する評価基盤
GitHubの発表によると、ReviewBenchは19のプログラミング言語にまたがる219件の公開プルリクエストを使います。プルリクエストとは、コードの変更案を確認してもらう単位です。人のレビュー、AI、静的解析などを組み合わせて検証した指摘を基準に、レビューするAIの結果を評価します。
普段のコードを自動で安全にする機能ではなく、レビューするAIを評価する仕組みです。研究プレビューとして、データセットや比較結果を確認し、自分のレビューシステムを評価する用途が案内されています。
同じ問題を解いても、得意なことが違う
問題がありそうな箇所を幅広く挙げるAIは、見落としを減らせる一方、確認する候補も増えるかもしれません。確実そうな問題だけを返すAIは読みやすくても、報告されない問題が残る可能性があります。何を重視するかは、体制や変更の影響によって変わります。
「指摘が正しい」と「見逃さない」は別の数字
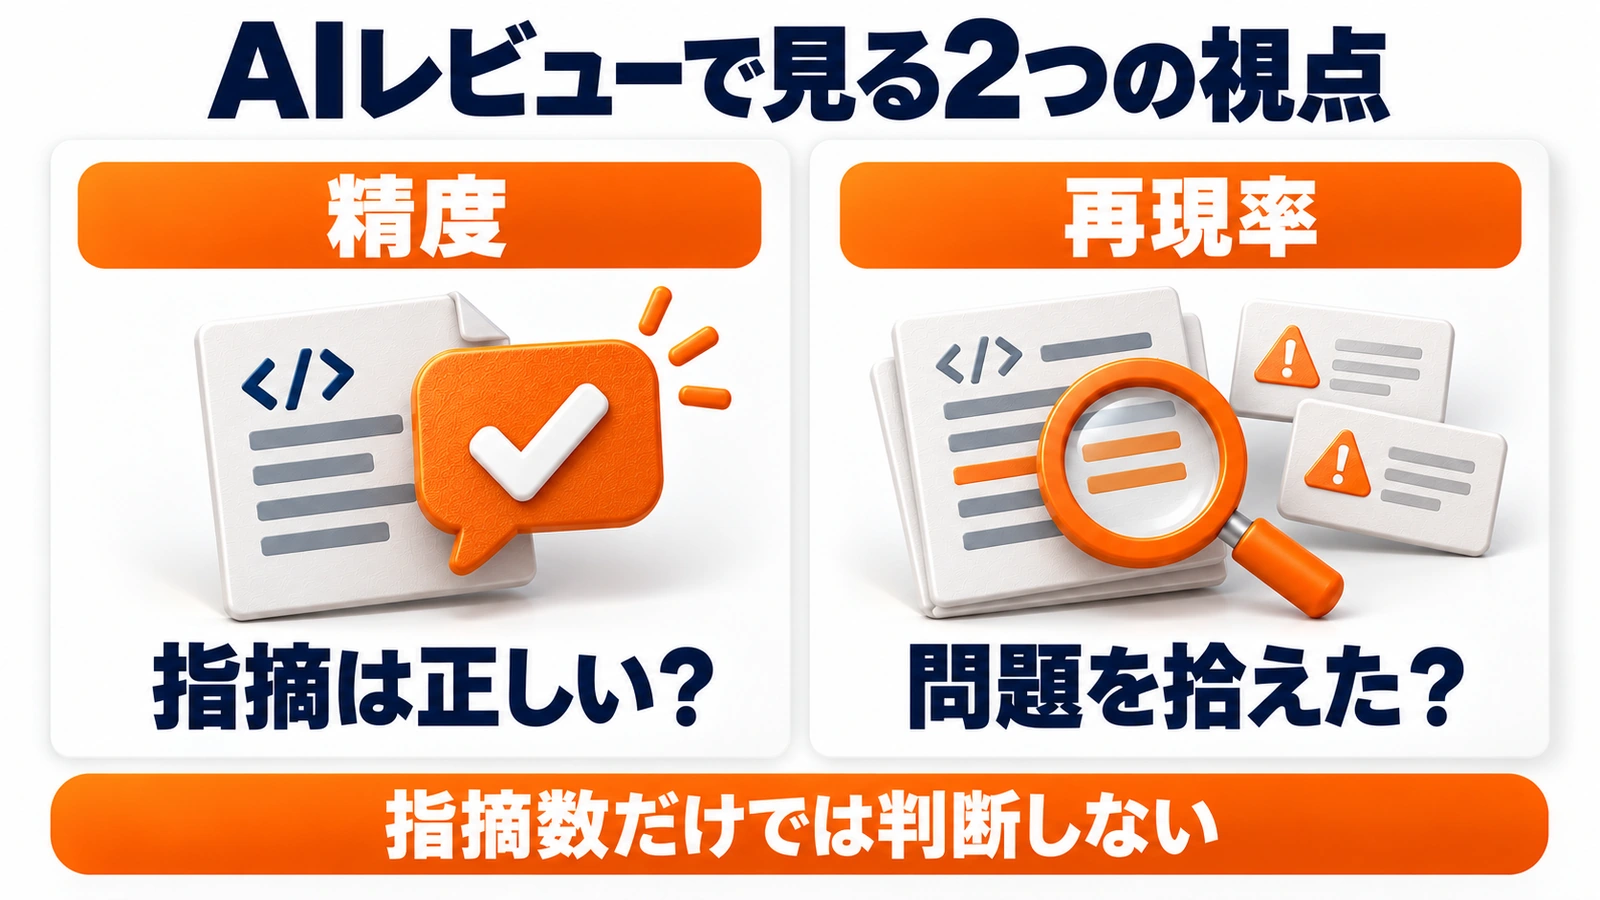
基本的な指標が、Precision(精度)とRecall(再現率)です。次のように分けると、結果を読みやすくなります。
| 指標 | 知りたいこと | 現場で気になる負担 |
|---|---|---|
| 精度 | AIの指摘のうち、正しいものはどれくらいか | 不要な指摘を確認する手間 |
| 再現率 | 確認済みの問題をどれくらい見つけたか | 見逃してしまう問題 |
実際のReviewBenchには、既知の指摘と新しい指摘の扱いなど、詳しい評価方法があります。次の例は公式スコアの再現ではなく、二つの概念を区別するために単純化したものです。
10件指摘したAIが、必ず優秀とは限らない
確認済みの問題が8件あるコードを考えます。AIが10件指摘し、そのうち6件が正しく、4件は誤りだったとします。この例での精度は6÷10で60%、再現率は6÷8で75%です。
「10件も見つけた」だけでは、不要な4件を調べる時間と、見つからなかった2件が見えません。指摘数・正しい指摘・未発見の問題を別々に数えると、次に直したい点が分かります。ここでの割合は説明用であり、特定製品の測定結果ではありません。
ランキングの前に、自分たちが困る失敗を決める
総合点で候補を選ぶ前に、どんなコードを、何のためにレビューしたいかを整理します。小さな社内集計ツールと、顧客情報を扱う公開サービスでは、同じ重み付けで判断できるとは限りません。
重要な問題を拾えているか
命名の改善が多数並んでいても、誤った計算やアクセス制御の不備を見逃していれば、目的に合わないことがあります。ReviewBenchでは重大度や分類ごとの内訳も示されるため、全体の順位に加え、関心のある種類の問題を確認します。
確認に使える時間と釣り合うか
少人数で運用する場合、正しいか不明な指摘が大量に返るとレビューが止まりやすくなります。一方、誤検知を減らすために見逃しが増えるなら、別の検査を組み合わせる必要があります。誰が調べ、どの時点で判断するかまで考えます。
導入前に、小さな比較で確かめる
公開評価は候補選びに役立ちますが、自社の言語や業務ルールと同じ条件とは限りません。次は、手元の環境で比べるための実践例です。
- 過去に不具合を直した変更など、正解を確認できる例を選ぶ。
- 比較するAIに、同じ変更内容と説明を渡す。
- 指摘を「正しい」「誤り」「判断保留」に分ける。
- 重要なのに指摘されなかった問題も記録する。
- 確認にかかった時間と通常のテスト結果を合わせて判断する。
社外へ渡せないコードを、比較のためにアップロードしないでください。共有可能なサンプルで試し、導入は担当者と条件を確認します。AI導入前のリスク評価も参考になります。
指摘を採用する前に、問題が起きる条件と修正後の動作を確かめます。「修正案が出た」「テストを一つ通った」「本番で使える」は同じ状態ではありません。
実務上の注意
ReviewBenchは研究プレビューです。対象データや評価方法は、その時点の公式情報で確認してください。単一の順位を根拠に、どの業務でも優れていると一般化しないことが大切です。
人が確認できないコードを、AI同士の多数決だけで安全と判断しないようにします。重要な変更では担当者のレビュー、テスト、必要なセキュリティ検査を組み合わせます。
まとめ
何件指摘したかより、正しい指摘と重要な問題をどれだけ拾えたかに注目しましょう。公開評価で候補を絞り、同じ条件の小さな例で手間と見逃しを比べると、仕事に合う使い方を考えやすくなります。
よくある質問
ReviewBenchで自分のコードを修正できますか?
主な役割はAIコードレビューの評価と比較です。コードの自動修正や本番の安全性を保証するサービスとして発表されたものではありません。
精度が高いなら、見逃しも少ないですか?
別の指標です。正しい指摘を少数返していても、未発見の問題が残る場合があります。両方を確認してください。
記事の60%・75%は実際の成績ですか?
概念を説明するための架空の件数から計算した例で、特定のAIの成績ではありません。
出典・参考情報
公式情報確認日:2026年10月7日(日本時間)。本文の実践例は説明用で、実機での性能測定や実体験を示すものではありません。
運営元について
AXメディアは、株式会社ジーズ AX事業部が運営しています。AX事業部では、AI研修・AIエージェント開発・ローカルLLM開発・補助金/助成金の活用支援を提供しています。