使い終えたサイトのログイン状態は、クラウドブラウザーの設定から、サイトごとに整理できます。
見積もりの確認に使ったサイトは、当面もう使わない。一方、別の業務サイトでは来週も作業を頼みたい。ChatGPTのクラウドブラウザーを使った後は、すべてのデータを消す前に、使い終えたサイトと続けて使うサイトを整理しましょう。この記事では、作業が終わった後に、どのサイトを対象にするか決める方法を扱います。
この記事でわかること
- 対象の判断:使い終えたサイトと継続するサイトを整理します。
- 操作の範囲:Browser dataのサイト単位と全体の消去を選びます。
- 作業の記録:成果物を残し、整理した範囲を短く記録します。
整理するのは、クラウド側に残るログイン状態
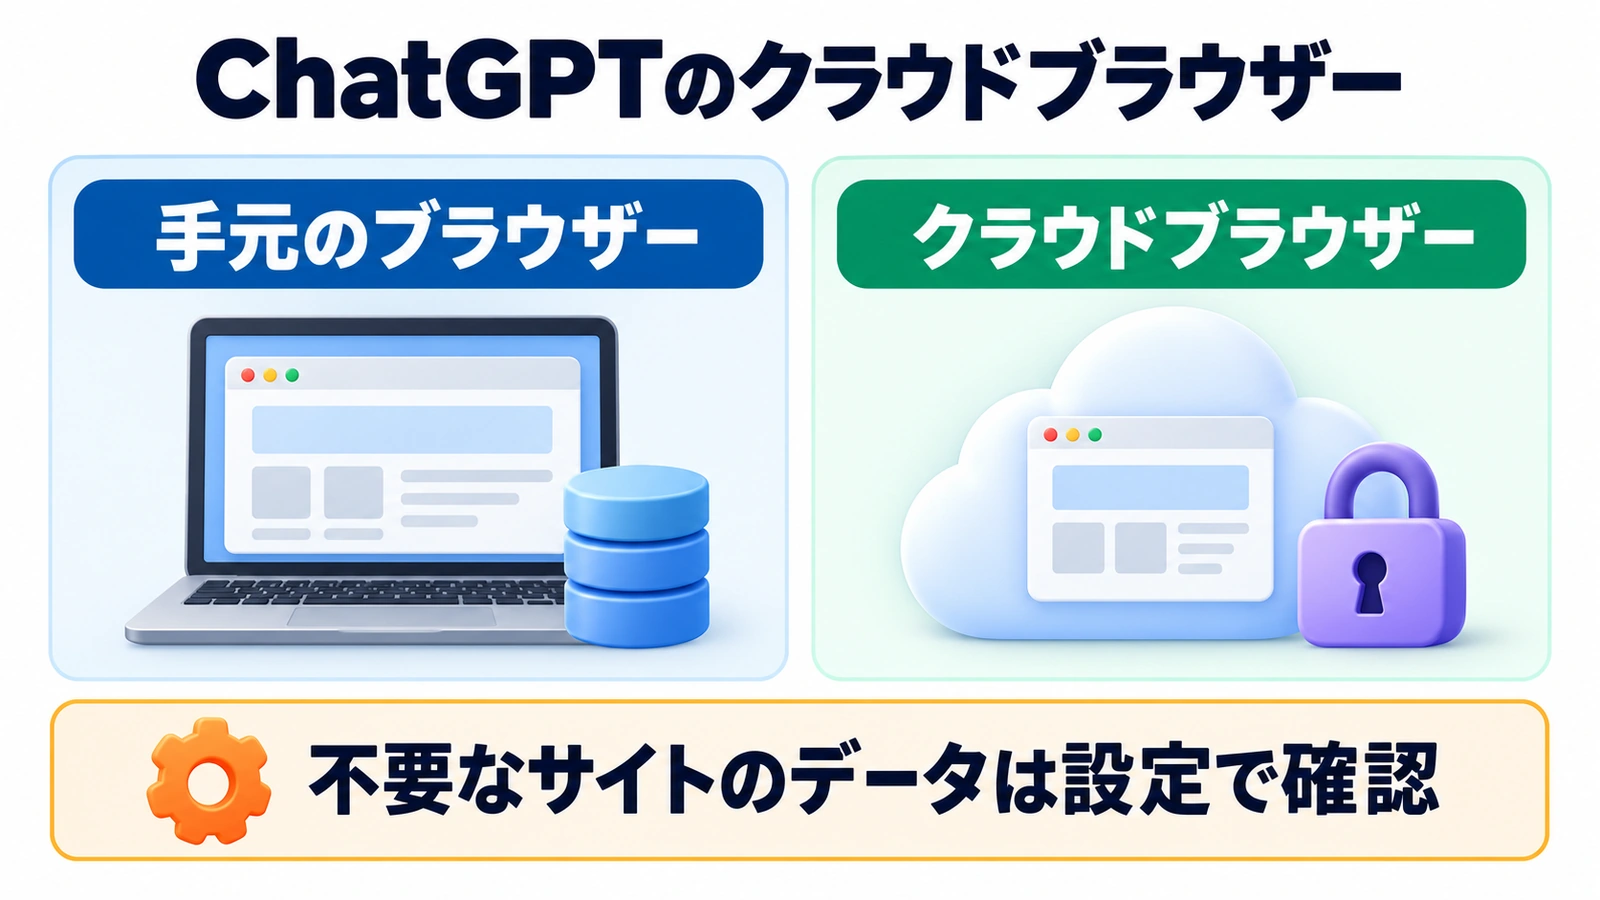
クラウドブラウザーは、手元のChromeなどとは別にログイン状態を持ちます。認証は後のタスクでも続く場合があるため、パソコンのブラウザーを閉じただけでクラウド側もログアウトしたとは考えません。公式の管理方法は、クラウドブラウザーのヘルプで確認できます。
開始時のログインではなく、作業後の整理を考える
今回は、すでに使ったサイトの状態をどう残すかが対象です。ログイン後に作業が進まない場合、原因が分からないまま保存データを一括消去する対処としては使わないでください。まず、どの作業が終わり、どの作業が残っているかを整理します。
使い終えたサイトを、今後の予定と並べる
次の表は、編集部が作成した架空の棚卸し例です。設定画面に同じ項目が自動表示されるという意味ではありません。今回の作業が完了したかと、次も使う予定があるかを、サイトごとに書き出します。
| サイト | 今回の作業 | 今後の利用 | 選ぶ対応 |
|---|---|---|---|
| A:見積サイト | 結果を保存済み | 当面なし | Aサイトだけのブラウザーデータ整理を検討 |
| B:業務ポータル | 今週分は終了 | 来週も使う | 必要性と社内ルールに沿って保持を判断 |
| C:予約サイト | フォーム入力が途中 | 未確定 | 消去に進まず、入力や成果物の扱いを先に決める |
同じサイトに私用と仕事用のアカウントがあるなら、どちらで作業したかも控えます。サイト名だけでは判断できないときは、記憶で埋めず、今回の会話や作業結果から確かめましょう。会社のアカウントは、継続利用や保存に関する社内ルールも確認します。
一つのサイトだけなら、そのデータを対象にする
たとえば、Aサイトで確認した見積もりを保存し、その作業を終えたとします。Bサイトでは来週も仕事を続ける予定です。Aだけのログイン状態を整理したいなら、Browser dataでAサイトのデータを対象にします。一サイトのために全体を消すと、ほかのサイトでも次の作業時にサインインが必要になります。 この操作範囲とログアウトの扱いは、公式ヘルプの「Privacy, cookies, and signed-in sessions」に基づきます。
全体を消すのは、ほかのサイトへの影響も決めてから
一つのサイトを使い終えたことと、全サイトのデータが不要になったことは同じではありません。対象を選ぶ前に、ほかのサイトで進行中の仕事や継続予定がないかを見ます。
| 目的 | 選ぶ対象 | 先に確認すること |
|---|---|---|
| Aサイトだけ使い終えた | Aサイトのブラウザーデータ | 結果を保存し、途中の操作がないか |
| クラウド側を全体整理したい | 全サイトのブラウザーデータ | ほかのサイトも再ログインが必要になる影響 |
| まだ入力・確認が途中 | 消去に進む前に作業状態を整理 | 未保存の入力と必要な成果物 |
Browser dataで対象を選び、整理した範囲を残す
公式の入口はSettings → Cloud browser → Browser data → Cookiesです。サイト単位と全体の消去を選べます。画面の名称は表示言語などで異なる場合があります。以下は、その操作を作業後の整理に使うための進め方です。
- 必要な成果物を保存し、入力や送信が途中でないことを確認する。
- Browser dataのCookiesを開き、対象サイトだけか全体かを選ぶ。
- 消去で対象サイトからログアウトすることを理解して操作する。
- 実施した日付と対象サイト・範囲を、作業記録へ短く残す。
確認のためだけにログインし直さない
不要になったサイトへ、確認のためだけにログインし直す必要はありません。次回、アカウントを使う仕事をする場合は、必要に応じて改めてサインインします。実際にどこまで操作したか分からない場合は、すべて整理済みと記録せず、確認できた範囲を残してください。
サイト内の文書やアカウントは、別の手続きで確認する
Browser dataは、クラウドブラウザーの保存データを整理する場所です。見積書などの文書削除やサイトのアカウント削除まで済んだとは扱いません。それらが目的なら、そのサービス側で必要な手続きを確認します。
同様に、ChatGPTの会話履歴や接続アプリの整理も、今回と同じ操作だとは考えないでください。作業記録には「Aサイトのブラウザーデータを整理」のように対象を書き、何を片付けたかを後から読める形にします。
実務上の注意
クラウドブラウザーは対応地域の有料ChatGPTプランのWorkで提供され、FreeとGoは対象外です。段階的な提供やワークスペースの権限で利用状況は異なります。
データを消す前に、未保存の入力や進行中の仕事を確認してください。再ログインが必要になった場合も、パスワードは会話欄へ貼り付けず、案内された安全な入力方法を使います。
この記事は2026年11月12日に公式ヘルプを再確認して整理した手順です。実アカウントでの消去操作や、内部の保存方式・保持日数の検証は行っていません。
まとめ
作業後の整理は、サイトごとに必要性を判断します。成果物と途中の操作を確認し、使い終えたサイトだけをBrowser dataの対象にすれば、継続利用するサイトへの影響を抑えて管理できます。
よくある質問
自分のChromeからログアウトすれば、クラウド側も整理できますか?
クラウドブラウザーは別のセッションを持ちます。クラウド側の保存データを整理したい場合は、ChatGPTのBrowser dataを対象にします。
一つのサイトだけ整理できますか?
公式ではサイト単位と全体の消去が案内されています。一サイトだけが対象なら、ほかのサイトへの影響を確認したうえで、そのサイトのデータを選びます。
消去したサイトを後でもう一度使えますか?
アカウントを使うタスクでは、改めてサインインが必要になります。サイト側の利用条件やアカウントの状態も関係します。
出典・参考情報
運営元について
AXメディアは、株式会社ジーズ AX事業部が運営しています。AX事業部では、AI研修・AIエージェント開発・ローカルLLM開発・補助金/助成金の活用支援を提供しています。