ChatGPTにPDFをアップロードできても、本文とグラフ・図では読み取り方が異なる場合があります。
会議資料や調査報告書を読み込ませたとき、文章は問題なく要約されているのに、「グラフの数値が回答に反映されない」「図で示した関係がうまく読み取られない」と感じることがあります。こうした場合、PDFそのものを読み込めていないとは限りません。
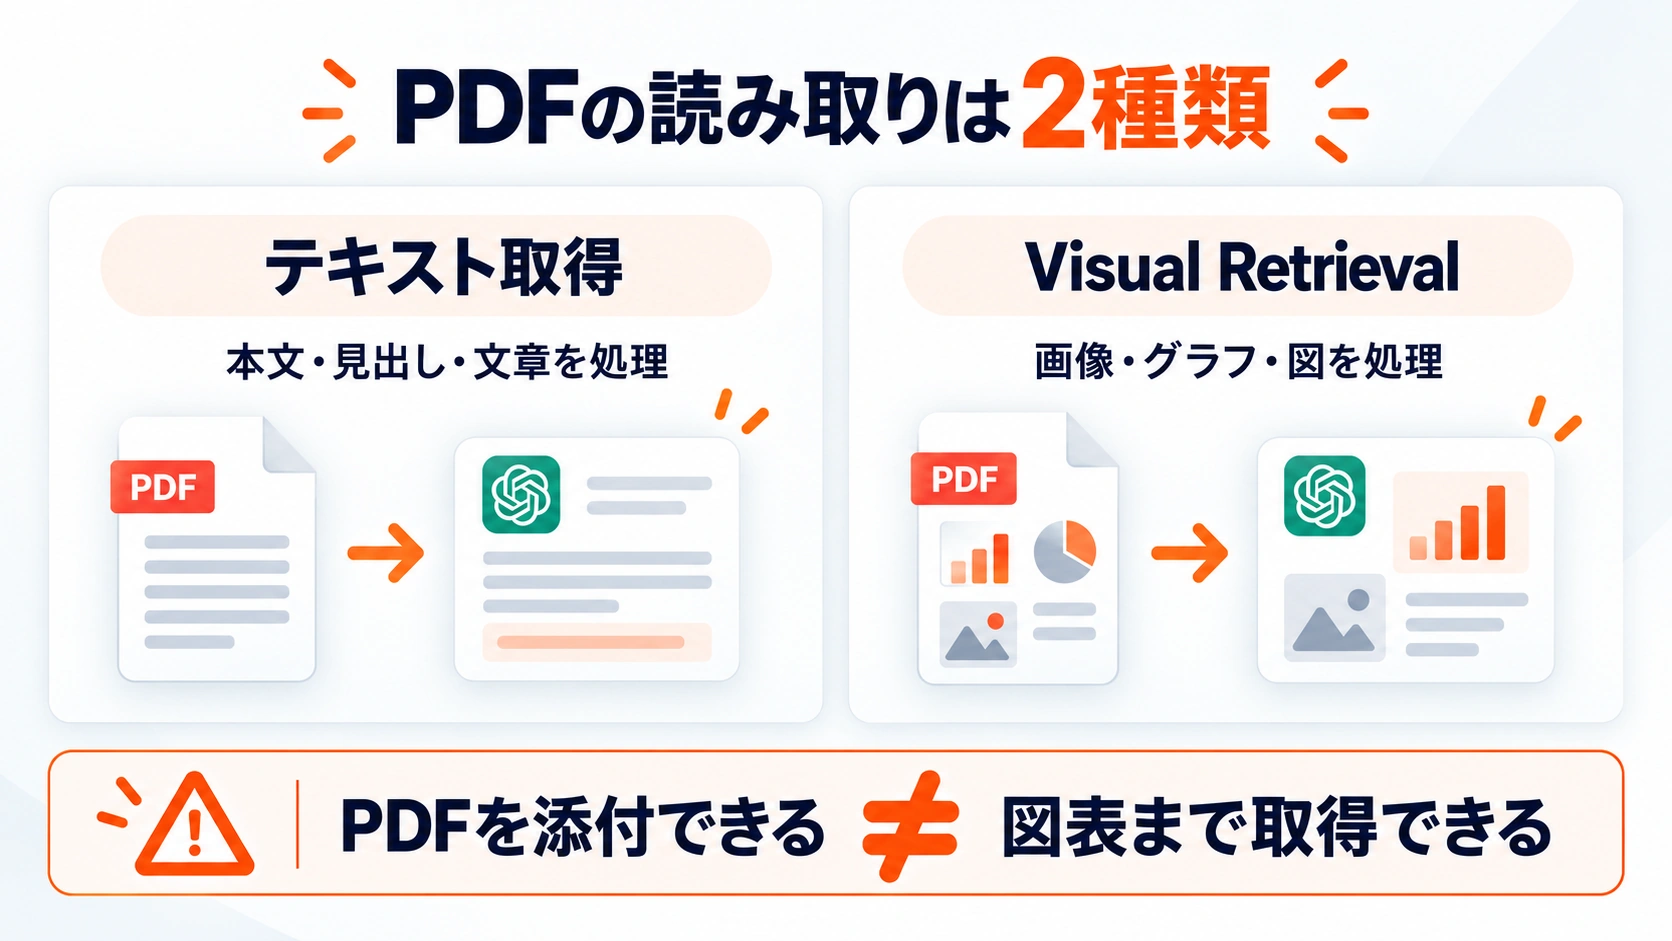
OpenAIでは、PDF内のテキストを読み取る処理とは別に、画像やグラフ、図などの視覚情報を扱う仕組みをVisual Retrievalとして案内しています。そのため、PDFを読めるかどうかだけでなく、図表まで読み取れる利用環境かを確認することが重要です。
この記事では、ChatGPTでPDF内の図表がうまく読み取れないときに確認したいポイントを順番に解説します。
この記事でわかること(結論)
- ファイル受付と図表取得:PDFをアップロードできても、埋め込み画像やグラフまで取得できるとは限りません
- プラン条件:OpenAIの現行FAQでは、PDFのVisual RetrievalはChatGPT Enterprise向けです
- 投入経路:Enterpriseでも、GPT KnowledgeやProject Filesに保存したPDFはテキストのみで処理されます
- 確認方法:プラン、投入経路、対象ページの順に切り分け、必要なら図表ページを画像として別添付して確認します
PDFをアップロードできることと図表を読み取れることは別
PDFをChatGPTへ正常にアップロードできても、PDF内の文字と図表が同じように読み取られるとは限りません。PDFには本文のテキストだけでなく、グラフ、画像、図解などの視覚情報も含まれているためです。
通常のテキストベースの処理では、PDF内の文字情報を取り出して回答に使います。一方で、グラフや図の中にしか書かれていない情報は、利用環境によっては読み取り対象になりません。
OpenAIのFile Uploads FAQでは、ChatGPT EnterpriseでPDFのVisual Retrievalを利用する場合を除き、文書ファイルは基本的にテキストとして処理され、埋め込まれた画像は処理対象外になると案内されています(出典:OpenAI「File Uploads FAQ」、2026年9月7日確認)。
たとえば、本文に「売上は増加した」と書かれていれば、その内容は回答へ反映されやすい一方、年度別の数値がグラフの中にしかない場合は、その数値まで読み取れないことがあります。つまり、PDFの本文を読めることと、図表の中身まで読めることは別と考えると分かりやすいです。
Visual Retrievalが使える条件を確認する
PDF内の画像やグラフ、図まで読み取るVisual Retrievalは、すべてのプラン・使い方で利用できるわけではありません。特にChatGPT Enterpriseでは、PDFをどこから追加したかによって処理方法が変わります。
OpenAIの現行FAQで案内されている違いを整理すると、次のとおりです(出典:OpenAI「Visual Retrieval with PDFs FAQ」、2026年9月7日確認)。
| 確認項目 | Visual Retrieval | 扱い |
|---|---|---|
| ChatGPT EnterpriseでPDFを会話中に添付 | 対象 | PDF内のテキストと埋め込み画像・グラフ・図を処理 |
| Enterprise以外のプランでPDFを添付 | 対象外 | PDFのテキストを中心に取得 |
| PDFをGPT Knowledgeへ登録 | 対象外 | テキストのみで取得 |
| PDFをProject Filesへ追加 | 対象外 | テキストのみで取得 |
| EnterpriseでProject内の会話中にPDFを添付 | 対象 | 会話中にアップロードしたPDFとしてVisual Retrievalを利用 |
特に注意したいのが、Project内で使っているPDFでも、保存場所によって扱いが異なる点です。Project Filesへ保存したPDFはテキスト中心の処理になりますが、EnterpriseでProject内の会話へその場で添付したPDFはVisual Retrievalの対象になります。
ChatGPT内でのファイルの置き場所そのものを整理したい場合は、ChatGPTのLibrary・Project Sources・添付の違いを整理した記事も参考にしてください。
ChatGPTでPDF内の図表を読み取れないときの確認手順
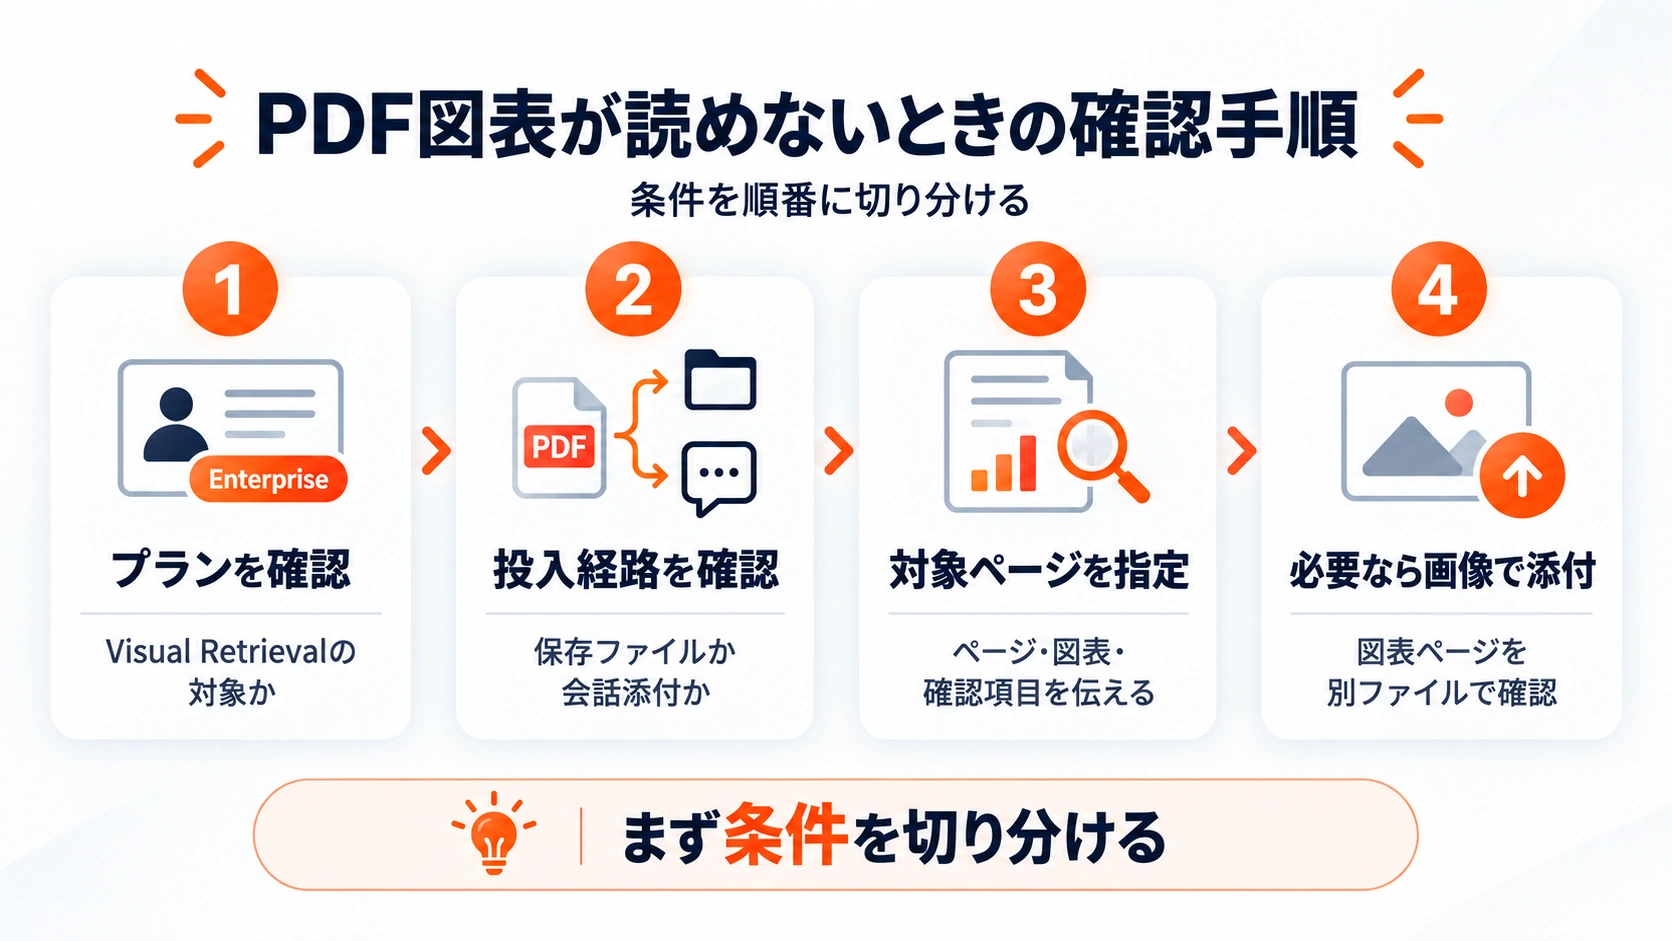
トラブル時は、同じ質問を繰り返すよりも、機能条件と対象ページを切り分ける方が原因を特定しやすくなります。次の順で確認します。
1.利用中のプランを確認する
最初に、PDFのVisual Retrievalを利用できる契約かを確認します。2026年9月7日時点のOpenAI公式FAQでは、この機能はChatGPT Enterprise専用です。対象外のプランであれば、プロンプトを細かくしても、PDF埋め込み図表の取得条件そのものは変わりません。
2.PDFをどこから投入したか確認する
Enterpriseを利用していても、GPT KnowledgeやProject Filesへ保存したPDFはテキストのみで処理されます。図表を含めて確認したい場合は、公開GPTとの会話中やProject内の会話中など、ユーザーが対話中にPDFを添付した経路かを確認します。
3.見てほしいページと図表を具体的に指定する
Visual Retrievalの対象条件を満たした後は、確認対象を明確にします。「8ページの棒グラフについて、2024年と2025年の差を説明してください」のように、ページ番号、図表の種類、確認したい項目を指定すると、どの情報を見てほしいのかを切り分けやすくなります。
4.必要なら図表ページを画像として別添付する
PDF内の図表が重要で、現在のプランや投入経路ではVisual Retrievalの条件を満たさない場合は、対象ページや図表部分をPNGやJPEGなどの画像として別添付し、その画像について質問する方法があります。OpenAIも、PDFのVisual Retrieval導入前は画像を別ファイルとしてアップロードして処理していたと説明しています。
ただし、本記事では同じPDFについて「PDFのまま」と「画像として別添付」の成功率を実測していません。画像に分ければ必ず読み取れる、精度が必ず上がるとは断定できません。図表の解像度や文字サイズ、画像自体の内容も確認してください。
実務上の注意
PDFの図表を業務で確認する場合は、ChatGPTが回答できたかどうかだけでなく、どの情報をもとに回答しているのかまで確認することが重要です。
「PDFが読めた」を一括りにしない
本文のテキストを要約できることと、画像・グラフ・図の内容まで読み取れることは別です。図表の数値が重要な資料では、本文にも書かれている情報なのか、図表にしかない情報なのかを分けて考えると判断しやすくなります。
Project Filesと会話中の添付は扱いが異なる
どちらもProject内で使うPDFですが、OpenAIのFAQでは処理方法が異なります。Project Filesとして保存したPDFはテキスト中心で処理される一方、EnterpriseでProject内の会話へ直接添付したPDFはVisual Retrievalの対象になります。
重要な数値は元PDFでも確認する
グラフの数値、割合、注記、凡例などを業務判断に使う場合は、ChatGPTの回答だけで確定せず、元のPDFも確認する方が確実です。特に会議資料や調査報告書、営業資料では、重要な数値や条件は該当ページまで戻って確認すると誤読を防ぎやすくなります。
まとめ
ChatGPTでPDF内の図表が回答に反映されないときは、単にPDFをアップロードできたかどうかではなく、その利用環境が図表を読み取れる条件を満たしているかを確認することが重要です。
2026年9月7日時点では、PDFのVisual RetrievalはChatGPT Enterprise向けで、EnterpriseでもGPT KnowledgeやProject Filesに保存したPDFはテキスト中心で処理されます。そのため、プラン、PDFを追加した場所、図表があるページの順に確認し、必要であれば図表部分を画像として別に添付するなど、読み取り方を切り替えることが有効です。
よくある質問
PDF内の図表を扱うときに迷いやすい点を整理します。
ChatGPTにPDFをアップロードできれば、グラフも読めていますか?
いいえ。PDFの受付と、埋め込まれたグラフや画像の取得は別です。OpenAIの現行仕様では、PDFのVisual RetrievalはChatGPT Enterprise向けです。
ChatGPT EnterpriseならProject FilesのPDF内グラフも読めますか?
Project Filesとして保存したPDFは、公式FAQではテキストのみで処理されます。EnterpriseでVisual Retrievalを使う場合は、Project内の会話中にPDFを添付する経路と区別してください。
GPT Knowledgeに入れたPDFは図表も検索対象ですか?
公式FAQでは、GPT Knowledgeに登録したPDFはテキストのみで処理されます。埋め込み画像やグラフをVisual Retrievalで取得する経路とは異なります。
図表を画像として別に添付すれば必ず読み取れますか?
必ず読み取れるとは断定できません。PDF埋め込み図表とは別の入力方法として確認できますが、解像度や文字サイズ、図表の複雑さなどの影響もあるため、元資料との照合が必要です。
関連する用語・出典
この記事で使った主な用語と一次情報です。仕様は変更される可能性があるため、公開前にも公式情報を確認してください。
- Visual Retrieval:PDF内のテキストだけでなく、埋め込まれた画像、グラフ、図などの視覚情報を扱う機能
- テキストベースの取得:文書からデジタルテキストを抽出して処理する方式。OpenAIは、対象外の文書では埋め込み画像を取得しないと説明しています
- Project Files:Projectで継続利用するファイルとして追加する保存経路。PDFのVisual Retrievalでは会話中の添付と区別されます
- GPT Knowledge:カスタムGPTの知識として登録するファイル。PDFはテキストのみで処理されます
- OpenAI公式:File Uploads FAQ、Visual Retrieval with PDFs FAQ(2026年9月7日確認)
※ChatGPTのプラン、ファイル処理、ProjectやGPTの仕様は変更される可能性があります。本記事は2026年9月7日時点のOpenAI公式情報をもとに整理しています。
運営元について
AXメディアは、株式会社ジーズ AX事業部が運営しています。AX事業部では、AI研修・AIエージェント開発・ローカルLLM開発・補助金/助成金の活用支援を提供しています。