Metaは2026年9月1日、リアルタイム音声認識モデル「Muse Voice Transcribe」を発表しました。日本語を含む25言語を重点的に検証し、20人を超える話者の識別と発話終了の検出をストリーミング処理で行います。
Muse Voice Transcribeは、完成した議事録を自動で作るサービスではありません。会話を聞きながら文字へ変え、「誰が話したか」「発言がどこで終わったか」を後続のシステムへ渡すための音声認識モデルです。
この記事では、日本語対応、話者識別、リアルタイム処理、料金、仕事へ組み込む際の注意点を整理します。
この記事でわかること(結論)
- 固有の価値:リアルタイム文字起こし、20人超の話者識別、発話終了検出を1つのモデルで行う
- 日本語対応:70以上の学習言語のうち、日本語は重点検証された25言語に含まれる
- 提供先:Meta Model API、Meta AI for Mac、Muse Codeから利用できる
- 料金:Meta Model APIでは1時間0.18ドル、1,000分3ドル
- 注意点:文字起こし結果の確認と、録音・処理に関する同意が必要
Muse Voice Transcribeとは?
Muse Voice Transcribeは、音声を受け取りながら文字と話者情報を返すリアルタイム音声認識モデルです。Meta Superintelligence Labsが開発した最初のリアルタイム音声知覚モデルで、Muse Spark系の自己回帰マルチモーダルモデルとして提供されます。
音声は80ミリ秒単位で処理され、モデルが「次の音声を待つか」「文字を出すか」を語ごとに判断します。難しい語では少し長く聞き、判断しやすい語では早く出力する適応型の遅延によって、速さと精度の両立を図ります(出典:Meta AI Research「Introducing Muse Voice Transcribe」、2026年9月1日)。
リアルタイム音声認識の3つの特徴
Muse Voice Transcribeの特徴は、文字起こしだけでなく、会話をリアルタイムで扱うための情報を同時に出せることです。
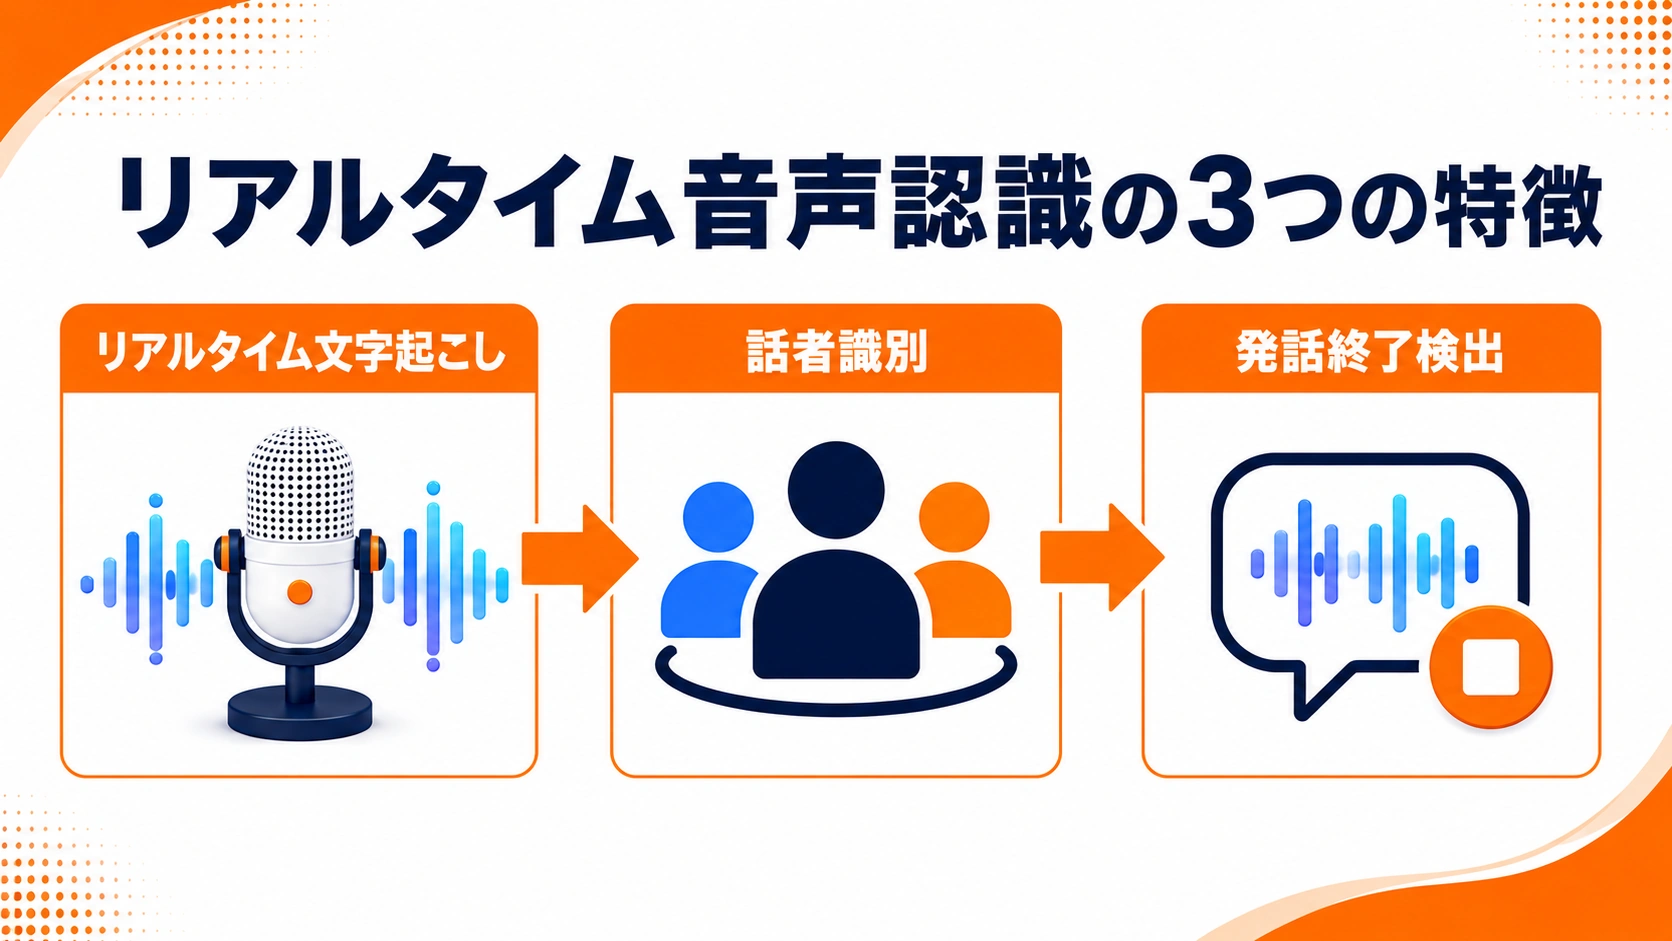
発言中に文字を返すストリーミングASR
録音が終わるまで待つのではなく、話している途中から文字を返します。ライブ字幕、通話中のオペレーター支援、音声入力など、結果をその場で使う用途に向きます。
Metaは、2026年9月1日時点でストリーミング音声文字起こしと公開話者識別ベンチマークの首位だと説明しています。ただし、順位は評価対象や更新時期で変わるため、導入時は自社の音声で確認する必要があります。
20人を超える話者をリアルタイムで識別する
diarizationは、音声から話者の切り替わりを見つけ、Speaker A、Speaker Bのように発言を分ける処理です。Muse Voice Transcribeは20人を超える話者と、1時間を超える音声をネイティブに扱い、後処理なしで話者ラベルを出せるとMetaは説明しています。
ただし、話者の声から実名を自動確定する機能とは限りません。会議参加者の氏名へ置き換える場合は、出席者情報と照合する工程が必要です。
発話の開始と終了を検出する
endpointingは、人が話し始めた時点と、話し終えた時点を検出する機能です。AIが返答を始めるタイミングや、1つの発言を確定する位置を判断しやすくなります。
沈黙や言い直しが多い会話では、固定の待ち時間だけで区切るより自然な対話を作りやすくなります。一方、通信状態や周囲の雑音で区切りがずれる可能性は残ります。
日本語と複数言語の会話に対応
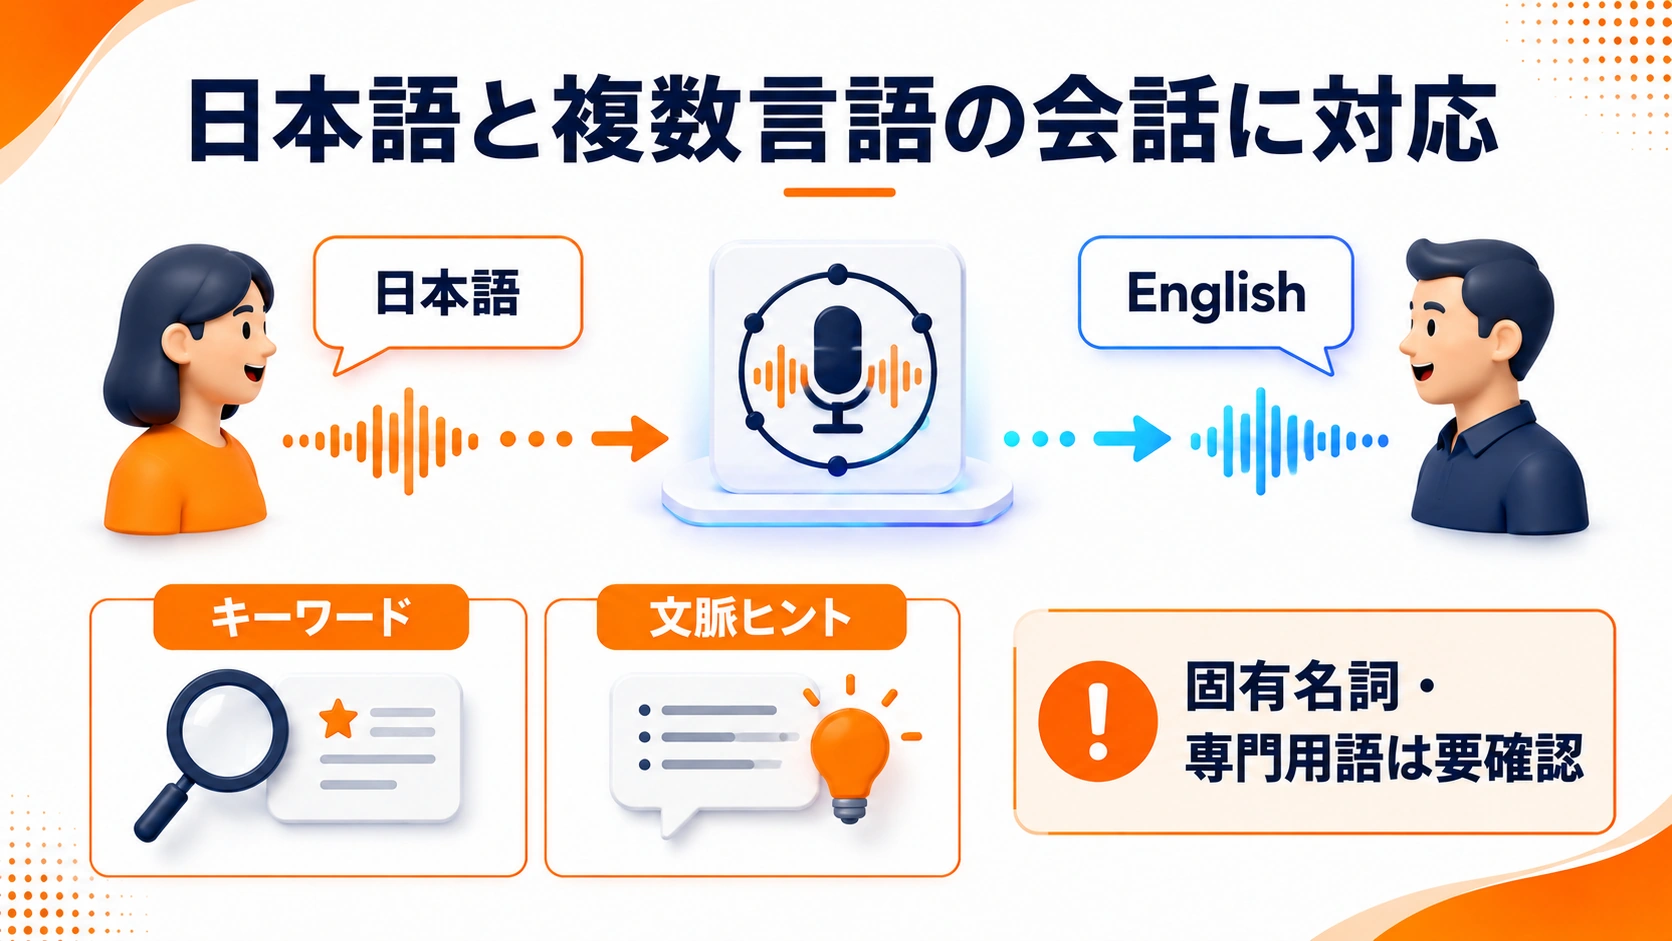
Muse Voice Transcribeは、日本語を含む複数言語の音声を文字へ変換できます。単に対応言語が多いだけでなく、1つの会話の中で複数の言語が混ざる場面にも対応しているのが特徴です。
日本語は重点的に検証された25言語に含まれる
日本語は、Metaが重点的に検証した25言語に含まれます。Muse Voice Transcribe自体は70以上の言語で学習されており、その中でも25言語が初期提供時の推奨言語として案内されています。
そのため、日本語の会議やインタビュー、商談なども利用候補になります。ただし、「日本語対応」と「どのような音声でも高い精度で認識できる」ことは同じではありません。
日本語と英語が混ざる会話も処理できる
実際の仕事では、「ミーティング」「API」「ChatGPT」のように、日本語の文章へ英語の商品名や専門用語が自然に混ざることがあります。Muse Voice Transcribeは、このように会話の途中で使用言語が切り替わるコードスイッチングにも対応しています。
さらに、認識時には言語だけでなく、キーワードや文脈に関するヒントを与えることもできます。会社名や製品名、専門用語など、通常の会話では推測しにくい言葉が含まれる場合に、認識を補助するために使えます。
日本語対応でも固有名詞や専門用語の確認は必要
対応言語に日本語が含まれていても、すべての方言、固有名詞、業界用語を正しく認識できる保証はありません。特に会社名、人物名、製品名、略語などは、一般的な文章から推測しにくいため誤変換が起こる可能性があります。
「日本語対応」だけで判断せず、自社で頻繁に使う固有名詞や専門用語までどの程度正しく文字にできるかを確認してから利用範囲を決めると安心です。
料金と利用方法
Muse Voice Transcribeは、開発者向けのMeta Model APIに加え、Meta AI for MacとMuse Codeで提供されています。APIでは、ライブ音声と既存の録音を処理できます。
| 項目 | 公式確認結果 |
|---|---|
| モデル名 | muse-voice-transcribe-1.0 |
| 料金 | 0.18ドル/時間、3ドル/1,000分 |
| 重点検証言語 | 25言語。日本語を含む |
| 話者数 | 20人超 |
| 長時間音声 | 1時間を超える入力に対応 |
| 提供先 | Meta Model API、Meta AI for Mac、Muse Code |
料金はMetaのモデルページに掲載されたAPI単価です(出典:Meta for Developers「Muse Voice Transcribe」)。為替換算額や、周辺システムの保存・要約・運用費は含まれません。
仕事ではどう使える?
Muse Voice Transcribeは、音声をその場で扱う機能を自社サービスへ組み込みたい場合に向きます。完成議事録を作る機能とは分けて考えます。
ライブ字幕と会話支援
オンラインイベント、窓口、通話などで、発言をリアルタイムに文字へ変えます。話者情報を画面表示や検索へ渡せば、複数人の会話も追いやすくなります。
多人数の会議を後工程へ渡す
話者ごとの文字起こしを、要約、決定事項抽出、タスク整理へ渡せます。ただし、Muse Voice Transcribe自体が決定事項や期限を理解して完成議事録にするわけではありません。
録音後の文字起こしモデルとの選び方は、Gemini 3.5 Transcribeの料金と使い方を整理した記事も参考になります。会議画面から直接メモを作りたい場合は、Google MeetのAI議事録機能が別の選択肢です。
専門用語を含む音声入力
キーワードと文脈のヒントを使い、社名、製品名、業界用語の認識を補助できます。実運用では、部署や業務ごとに重要語を絞り、誤変換の確認表を作ると改善しやすくなります。
実務上の注意
音声データには、内容だけでなく声や参加者情報が含まれます。精度と同時に、取得・保存・共有のルールを決めます。
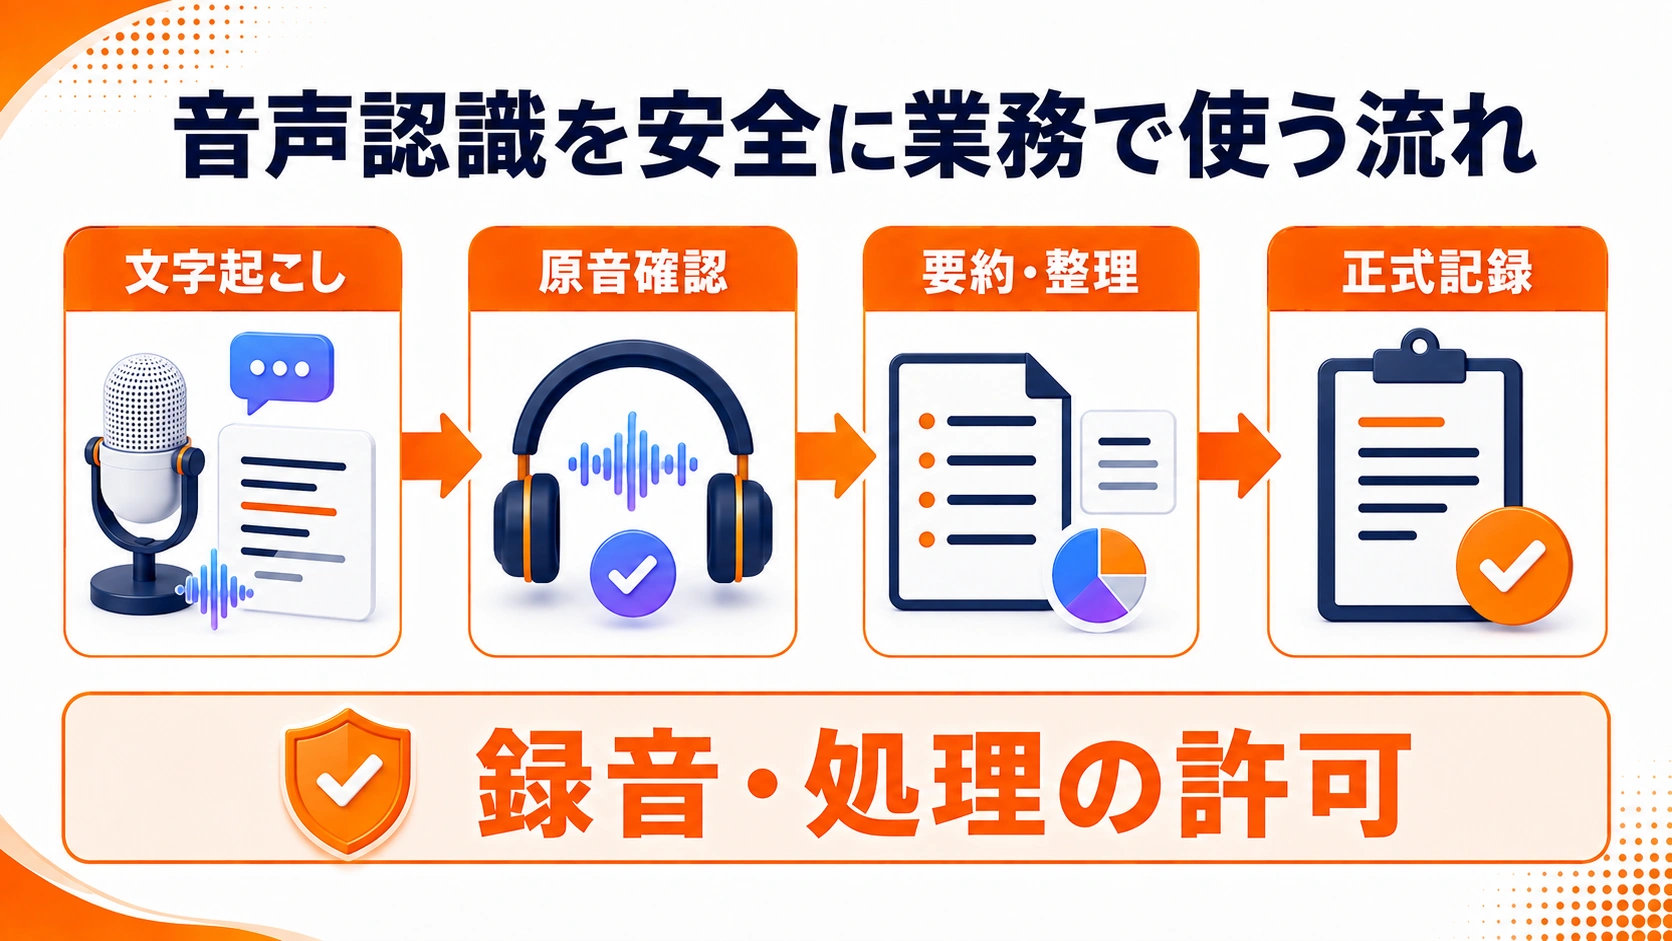
文字起こし結果を原音と照合する
Metaのデモにも、AI生成の文字起こしは不正確な場合があると明記されています。契約、金額、氏名、医療・法務、安全に関わる発言は、元音声と人の確認を残します。
録音・処理の許可を得る
デモ利用時にも、処理する音声を録音する許可があることの確認が求められます。社内会議、顧客通話、イベントで使う場合は、参加者への案内、利用目的、保存期間、共有範囲を決めます。
議事録作成までの後工程を設計する
音声認識が正しくても、要約、担当者、期限の抽出で誤りが生じることがあります。文字起こし、要約、人の承認を分け、どの段階のデータを正式記録とするか明確にします。
まとめ
Muse Voice Transcribeは、リアルタイム文字起こし、20人を超える話者識別、発話終了検出、日本語を含む多言語処理に対応した音声文字起こしモデルです。API料金は1時間0.18ドルと案内されており、多人数の会議やリアルタイム処理を想定した用途で活用できます。
ただし、文字起こしだけで完成した議事録になるわけではありません。導入する場合は、自社の音声環境で精度を確認したうえで、参加者への同意確認や、文字起こし後の要約・内容確認まで含めて運用方法を決めておくことが重要です。
よくある質問
Muse Voice Transcribeは日本語に対応していますか?
はい。日本語は、Metaが重点的に検証した25言語に含まれます。ただし、固有名詞や専門用語の精度は実際の音声で確認が必要です。
Muse Voice Transcribeだけで議事録を作れますか?
文字起こしと話者識別はできますが、決定事項やタスクを整理した完成議事録は別の処理です。要約モデルと人の確認を組み合わせます。
20人を超える会議でも話者の名前が分かりますか?
話者をラベルで分ける機能はありますが、ラベルと実名の対応は別途確認が必要です。出席者情報と照合してください。
Muse Voice Transcribeの料金はいくらですか?
Meta Model APIの掲載価格は1時間0.18ドル、1,000分3ドルです。保存、要約、周辺システムなどの費用は別に見積もります。
関連する用語・出典
- ASR:音声を文字へ変換する自動音声認識
- diarization:会話の中で誰が話したかを話者別に分ける処理
- endpointing:発話の開始と終了を検出する処理
- 公式発表:Introducing Muse Voice Transcribe
- モデル・料金:Muse Voice Transcribe model page
運営元について
AXメディアは、株式会社ジーズ AX事業部が運営しています。AX事業部では、AI研修・AIエージェント開発・ローカルLLM開発・補助金/助成金の活用支援を提供しています。