MASSは、AI同士の協働で得た良い実行例を学習に戻し、同じモデルの能力改善を目指す研究です。
AIを何体も並べれば、より良い仕事ができるのでしょうか。Sakana AIが2026年10月12日に発表したMASSは、その先にある「協働の成果から、モデル自体をどう改善するか」を扱っています。
注目したいのは、役割を分けたAIの会話だけではありません。仕事の進め方を探し、実行結果を選び、学習に戻すところまでをつなげた点です。一方で、成果は研究用の評価で確かめられた範囲に限られます。1.2〜1.6倍という数字を、そのまま仕事の生産性や費用削減率に置き換えることはできません。
この記事でわかること
- MASSの仕組み:同じモデルが役割を分担し、協働の実行例を学習に戻す流れ
- 成果の読み方:出力トークンを考慮した評価と、改善が広がらなかった領域
- 実務への示唆:自社でAIの改善を評価するときに分けて見る指標と注意点
MASSは「AIのチーム」からモデルの学習につなげる研究
MASSはMulti-Agent Self-Supervisionの略です。複数のエージェントを使いますが、土台にあるモデルを別々に用意する方式ではありません。一つの共有モデルが、課題を解く役、進め方を改善する役、結果を評価する役を担います。
たとえば、調べる担当と検証する担当を分けるだけなら、モデルの重みは変わりません。MASSでは、うまく働いたチームの実行記録を選び、それを共有モデルの追加学習に使います。更新後のモデルで再びチームを動かすため、「進め方の改善」と「モデルの改善」が循環する構造です。
同じモデルを分業させても、独立した専門家が増えるわけではない
役割が違えば、注目する情報や確認の仕方を変えられます。ただし、全員が同じモデルを使うため、共通の思い込みや苦手分野が残る可能性があります。「複数のAIが賛成したから正しい」と判断しないことが、仕組みを理解する第一歩です。
自己改善は、進め方を探す段階と学習する段階に分かれる
まずモデルを固定し、より良い進め方を探す
内側のループではモデルの重みを固定し、エージェントの役割、指示、返す情報、呼び出す順序などを調整します。候補の進め方で課題を実行し、保持している案と比較しながら改善を重ねます。
ここで変えているのは、AIへの依頼を含むワークフローです。文章を長く考えさせるだけではなく、誰が何を受け持ち、次の担当へ何を渡すかを探索します。
選んだ実行例を学習に戻し、共有モデルを更新する
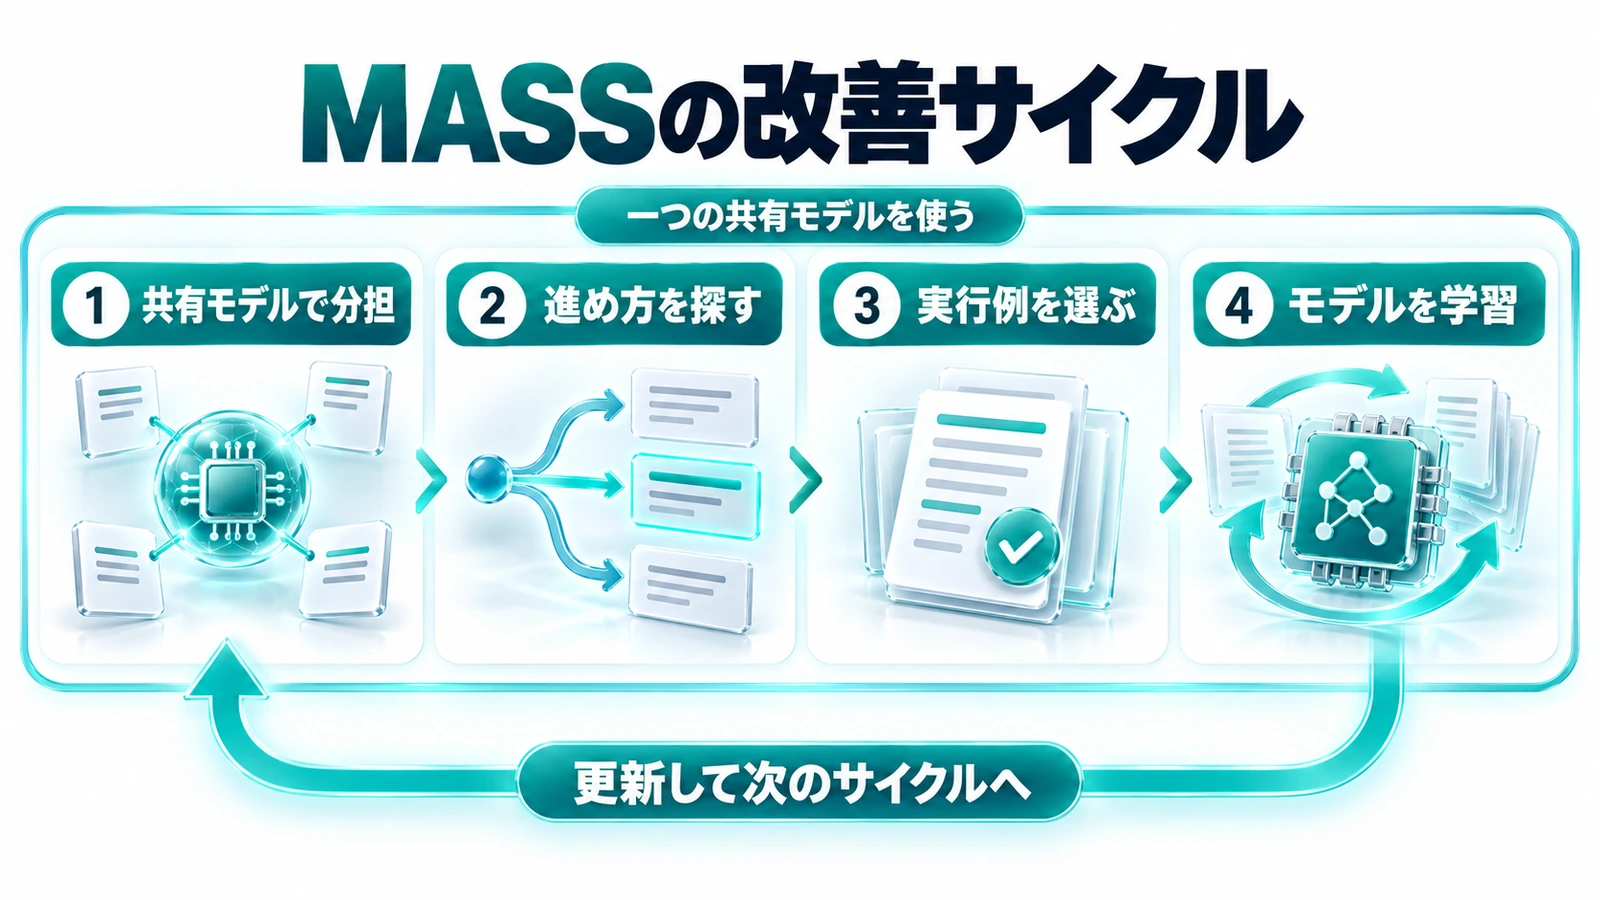
外側のループでは、選んだワークフローを複数回実行し、得られた記録を評価します。選抜した記録を追加学習に使い、更新したモデルが再び課題の実行、進め方の改善、評価を担います。
流れを大づかみにすると、次の四段階です。実行記録が学習に戻る点が、単に複数のAIを会話させる使い方との重要な違いです。
- 共有モデルを使って、役割分担したチームを組む。
- 課題の進め方を探し、候補を実行する。
- 実行結果を評価し、学習に使う記録を選ぶ。
- 共有モデルを追加学習し、次の改善サイクルへ進む。
1.2〜1.6倍は何を測った数字か
Sakana AIはQwen3.6-27Bを出発点に、MASSを2サイクル適用した結果を報告しています。研究課題向けの四つの評価では、出力トークン数を考慮した性能が1.2〜1.6倍になりました。
これは「同じ指示で作業時間が半分になった」「人の仕事が1.6倍速く終わった」という測定ではありません。出力の長さと評価スコアの関係を見た結果です。モデルを学習させる費用、ワークフローを探索する費用、人が確認する時間を含めた全体の採算は、別に調べる必要があります。
コードの評価では、同じ改善が確認されていない
研究課題で得た改善が、あらゆる仕事に移ったわけでもありません。公式解説では、コード関連のTerminal-Bench 2.0とSWE-bench Verifiedについて、同じ出力トークン正規化の比率がそれぞれ0.96と0.94と示されています。この指標では、出発点を上回っていません。
したがって、MASSを「どんなAIの仕事も自動で良くする方法」と捉えるのは早計です。何の課題で学習し、どの課題で評価したかをセットで読む必要があります。
発表日と論文の公開日は分けて読む
企業による発表は2026年10月12日です。一方、論文はarXivに10月8日15時44分UTC、日本時間では10月9日0時44分に投稿されています。今回のニュースは10月12日の発表を受けたものであり、論文が同日に初公開されたという意味ではありません。
自社のAI改善に引き寄せるなら、評価を三つに分ける
以下は研究結果を踏まえた編集部の判断例です。MASSを導入した実測結果や、論文で検証された業務手順ではありません。日々のAI活用でも、改善の判断を混ぜないための観点として使えます。
| 見る対象 | 確かめたいこと | 混同しない指標 |
|---|---|---|
| 成果の品質 | 根拠の誤りや必要情報の欠落が減ったか | 文章が長くなったことと、正確さ |
| 処理の効率 | 同じ品質を保って出力や処理の負担が減ったか | 出力トークンの削減と、総費用 |
| 人を含む運用 | 確認や修正を含めて仕事が終わるまでの負担が減ったか | AI単体の成績と、現場の生産性 |
練習に使わない課題を残しておく
たとえば社内の調査メモを改善するなら、過去のメモの一部で依頼文を調整し、残りの題材で確かめます。調整に使った例だけで点数が上がっても、初めての題材で役立つとは限らないためです。
比較時は、同じ資料と同じ合格基準を使い、誤り、欠落、確認時間を記録します。改善に使う例と、改善を確かめる例を分けるという判断が重要です。人とAIの実際の分担については、AIエージェントと人の役割分担を整理した記事も参考になります。
実務上の注意
MASSでは評価する役も共有モデルが担います。そのため、モデルが見落とす誤りを良い実行例として選び、次の学習で強めてしまう可能性があります。公式解説も、自己評価の盲点や改善の停滞を課題として挙げています。
実務では、AIの評価だけを最終合格にせず、根拠との照合や、用途に応じた人の確認を残す判断が必要です。また、研究用の実行記録を学習に使う仕組みと、自社の機密情報を学習に使ってよいかという判断は別です。利用環境とデータの取り扱い条件を確認してください。
まとめ
MASSの見どころは、AIの役割分担で得た良い実行例を、共有モデルの学習につなげたことです。研究課題では効率を考慮した性能向上が報告された一方、コードの評価では同じ広がりは確認されていません。
改善した課題、評価指標、全体の費用を分けて読む。この三点を押さえると、「AIが自分で賢くなる」という言葉だけに引っ張られず、研究の成果と限界を判断できます。
よくある質問
MASSは複数の異なるAIモデルを組み合わせる仕組みですか?
今回の研究では一つの共有モデルを使い、課題の実行、ワークフローの改善、結果の評価を役割として分けています。異なるモデル同士の独立した判断を集めることと同じではありません。
1.6倍なら、仕事も1.6倍速くなりますか?
そうは言えません。報告された数字は研究用の評価スコアを出力トークン数で正規化した性能です。人の確認時間や学習・探索の費用まで含めた業務全体の生産性ではありません。
通常のチャットで役割を分ければMASSになりますか?
役割分担だけでは同じ仕組みにはなりません。MASSはワークフローの探索に加え、選んだ実行記録を共有モデルの追加学習へ戻すサイクルを含みます。
出典・参考情報
運営元について
AXメディアは、株式会社ジーズ AX事業部が運営しています。AX事業部では、AI研修・AIエージェント開発・ローカルLLM開発・補助金/助成金の活用支援を提供しています。