スキルの改善を評価するときは、先に合格条件を決め、実行できた証拠と出力の正しさを別々に確認します。
社内向けのスキルを作り、AIから「使いました」と返ってきた。それでも成果物に古い形式が混ざる。こんなとき、スキルをさらに長く書き直す前に、何をもって改善と判断するかをそろえる必要があります。
Microsoftは2026年10月9日、Agent Experience(AX)Practitioner Playbookを発表しました。AIコーディングエージェントがSDK、API、スキルなどを適切に使うかを、提供・保守する側が評価するための資料です。ここでのAXはAgent Experienceの略です。(出典:Microsoftの発表)
この記事でわかること
- 評価の準備:合格・不合格・対象外を先に決める
- 確認方法:実行の検査と内容の採点を分ける
- 改善の判断:同じ条件で比較し、記録を残す
「スキルがある」と「役に立った」を分けて評価する
今回の資料は、スキルがインストールされているかを調べるだけの案内ではありません。そのスキルや資料によって、成果物が正しくなったかを判断するための手順を扱います。
Microsoftは、拡張機能が読み込まれていない、読み込まれたが呼び出されていない、使われたが適用を誤った、という状態を区別しています。結果が悪いという一点だけで同じ修正を施すと、原因と対策がずれるためです。(出典:発表記事)
最初に、評価する小さな仕事を1つ決める
たとえば、社内SDKを使うサンプルアプリを作成するスキルなら、「最新の方法で良いアプリを作る」では確認範囲が広すぎます。「指定したSDKで、テスト用データを読み込んで一覧表示する」まで絞ると、期待する成果物を確認しやすくなります。
評価票には、良い例だけでなく悪い例も用意する
プレイブックでは、各判定に確認対象・合格条件・不合格条件・対象外の条件を定め、正解と不正解が分かっている成果物で採点のぶれを確認します(PDFの第5章)。次はその考え方を使った、編集部による評価票の作成例です。特定製品の推奨仕様ではありません。
| 確認対象 | 合格の例 | 不合格の例 | 対象外の例 |
|---|---|---|---|
| 指定SDK | 依頼したパッケージと許容バージョンを使う | 別のSDKや許容外の版を使う | その機能を使わない課題 |
| 入力の扱い | 空のテストデータでも定めた表示になる | 例外で処理が止まる | 入力を受けない課題 |
| 成果物の配置 | 指定した保存先に必要ファイルがある | 回答文だけでファイルがない | 説明だけを求めた課題 |
ここで大切なのは、採点する人が補って解釈しなくて済むことです。「最新」「適切」「分かりやすい」と書く代わりに、許すバージョン、必要なファイル、想定する入力を具体化します。一つの項目でSDK・認証・表示をまとめて採点するより、分けた方が失敗箇所を追いやすくなります。(出典:プレイブック第5章)
動いたかどうかは、採点コメントとは別に確かめる
実行の検査を通ってから、内容を比較する
プレイブックのゲートは、正しい技術を使ったかという前提確認から始め、ビルド・テスト・実行へ進む機械的な検査です。デプロイが課題に含まれるなら、その確認は最後に置きます。動かない出力に高い内容点が付くことを防ぐ狙いです(PDFの第2章)。
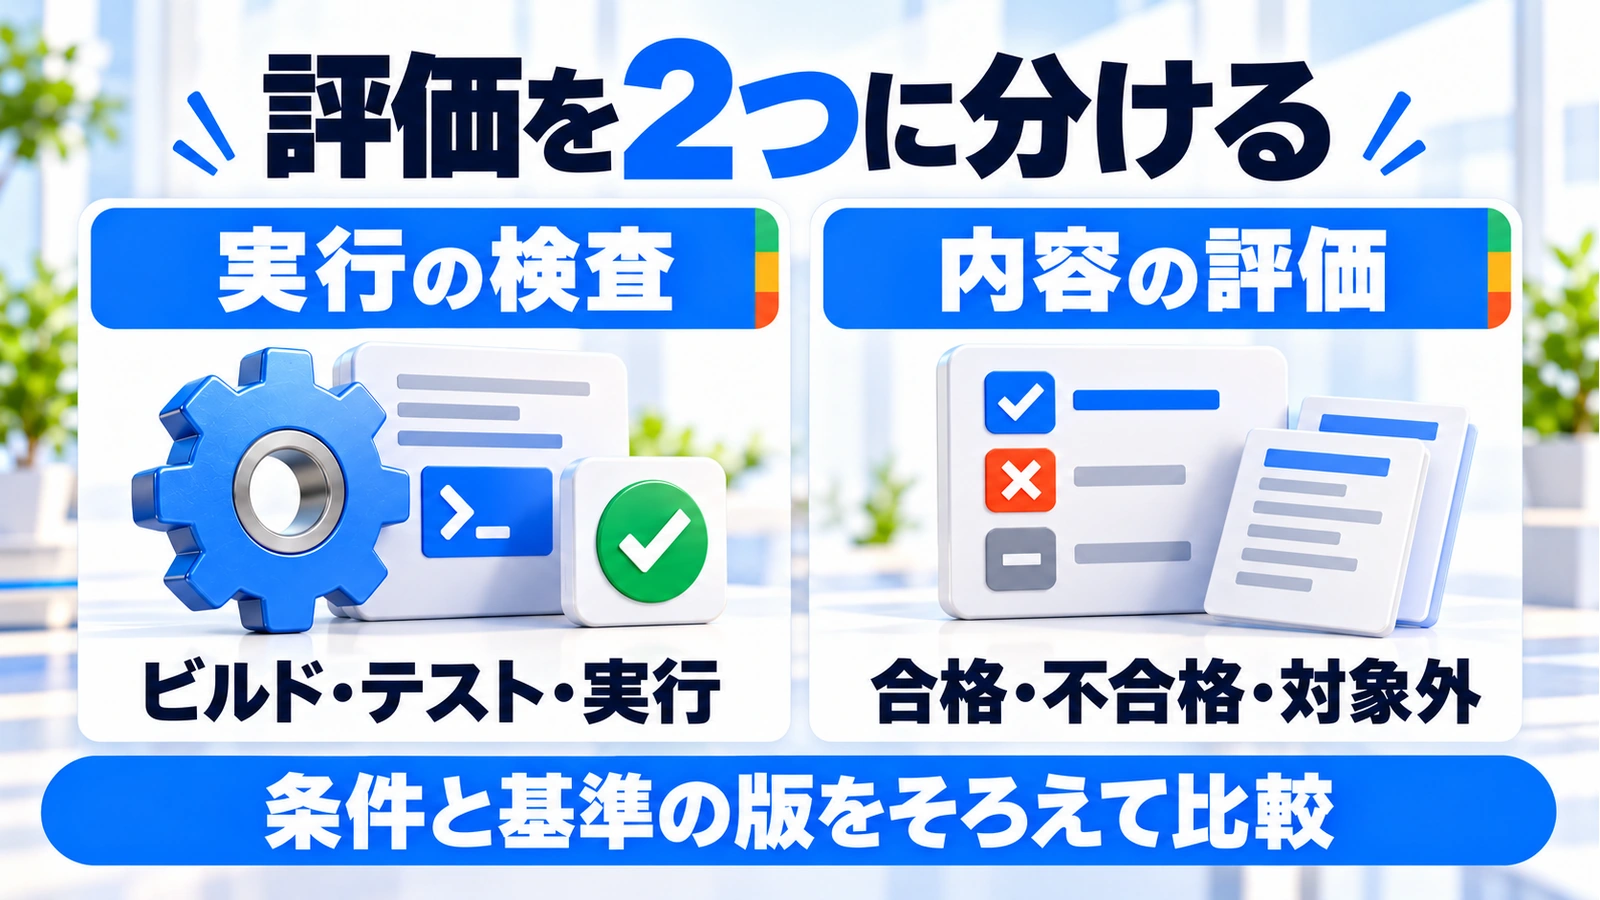
前のサンプルアプリなら、AIが「動作確認済み」と書いたかではなく、テスト結果や実行ログを確認します。接続情報がなく実行できなかった場合は、実行成功と同じ欄に入れず、未確認の理由を残します。
文書制作へ応用する場合も、考え方は使えます。たとえば「ファイルが開く」「必須欄が埋まっている」という機械検査と、「説明が根拠に合っている」という内容評価は別です。これは編集部による応用例で、Microsoftが文書制作向けの完成評価表を公開したという意味ではありません。
同じ条件の比較と、記録を一緒に残す
最初は拡張なしと、スキル1つを比べる
資料では、拡張なしの基準結果を取り、スキルなどを一つずつ追加して比較します。モデルだけでなく、OS、実行アプリ、設定も結果へ影響するため、比較条件を記録します。また、試行を繰り返してばらつきを見る方法として最低5回を出発点に挙げていますが、5回で統計的な確実さを得られるとはしていません。(出典:プレイブック第2・6章)
自分の検証表には、課題、入力ファイルの版、スキルの版、環境、結果ファイル、判定、所要時間を並べておくと便利です。たとえば「新版で保存形式は直ったが、処理時間が大きく増えた」なら、品質向上と運用負担を別々に検討できます。
結果を見てから合格条件を緩めない
評価基準を変更した場合は版を分け、過去の結果にも当時の基準を対応させます。違う物差しの点数を、そのまま改善率として扱わないという考え方です。(出典:プレイブック第5章)
たとえば「一覧表示まで」が目標だったのに、新版だけ「データ取得まで」で合格にすると、点数は上がっても仕事が改善したとは言えません。課題自体を変えることは可能ですが、以前の評価と直接比較できるかは確認が必要です。
次に直す場所を、観測できた証拠から選ぶ
スキルを使っていないなら、呼び出し条件や利用できる状態を確認する。読んだ後に古い方法を選んでいるなら、参照資料や指示の競合を調べる。出力は正しいのに検査が落ちるなら、検査側の条件を確認する。このように、出力と実行記録を組にして、変更する箇所を絞るのが実務上の使いどころです。
指示文自体の整理が必要になった場合は、GPT-6 Astra向けスキル・プロンプトの見直し方も参考になります。今回の評価票は、直す前後を同じ基準で判断するために使います。
実務上の注意
AIに評価を補助させても、自社の正しい仕様や許容範囲まで任せきりにしないでください。仕様を知る担当者が基準を確かめる必要があります。また、実行ログに保存された秘密情報をそのまま社外へ共有しないよう、記録の範囲も決めます。
この記事はプレイブックの読解と、明示した作成例による解説です。特定スキルの性能向上を実測した結果ではありません。公開された学習用スキルの評価値を、自社タスクの成功率へ読み替えることもできません。
まとめ
スキルの良し悪しを判断するには、合格条件を先に決め、実行の検査と内容評価を分け、同じ条件で比較することが出発点です。小さな課題と評価票を用意すれば、何度も指示を書き足す前に、どこを直すべきかを話し合いやすくなります。
よくある質問
スキルを作る担当者以外にも役立ちますか?
AIが使うSDK、API、MCP、ドキュメントなどを提供・保守する担当者が主な対象です。利用者の感想を、再現できる評価課題へ整理する際にも使えます。
5回成功すれば品質を保証できますか?
いいえ。資料の5回は、ばらつきを見るための実用的な出発点です。重要性や結果のばらつきに応じて、試行や条件を増やす必要があります。
AIがスキルを使ったと言えば評価できますか?
自己申告だけでは成果の正しさは判断できません。出力、検査結果、参照やツール利用を確認できる記録を合わせて判断します。
出典・参考情報
運営元について
AXメディアは、株式会社ジーズ AX事業部が運営しています。AX事業部では、AI研修・AIエージェント開発・ローカルLLM開発・補助金/助成金の活用支援を提供しています。